Генерация и монтаж видео с ИИ
Видео перестало быть нишевой темой, сегодня это база. Клиенты всё чаще ждут не статичный визуал, а короткий ролик для сторис, лендинга или презентации. Хорошая новость: принципы промптинга здесь во многом повторяют тема «Генерация изображений». Добавляется только измерение времени и движение камеры, и с этим ты справишься.
Text-to-video vs image-to-video
Text-to-video генерирует ролик с нуля из текстового описания. Это быстро, но контроля над композицией, лицами и объектами меньше. Image-to-video оживляет уже готовое статичное изображение. По шагам это медленнее, потому что сначала нужна хорошая картинка. Зато результат гораздо предсказуемее: композиция, свет и объект уже зафиксированы на этапе изображения. Для дизайнерской работы почти всегда лучше идти вторым путём. Сначала доведи кадр до идеала по теме «Генерация изображений», а затем оживи именно его.
Исходный кадр
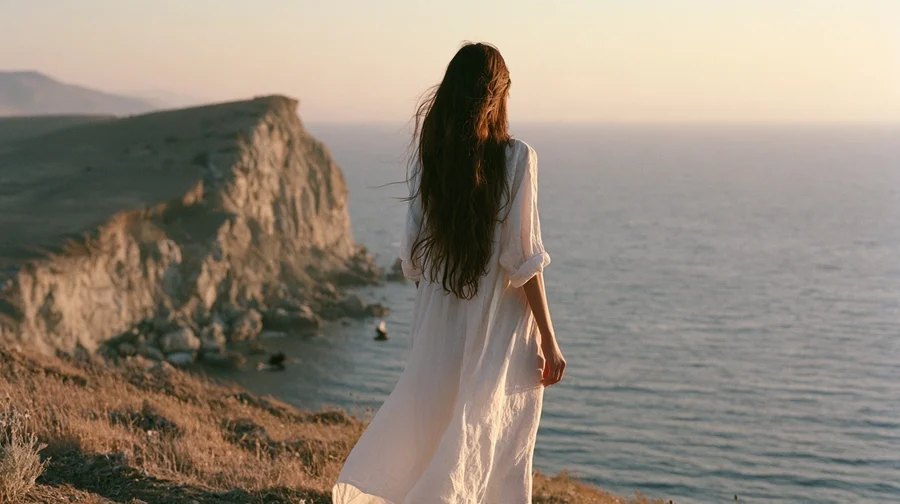
1,7 с
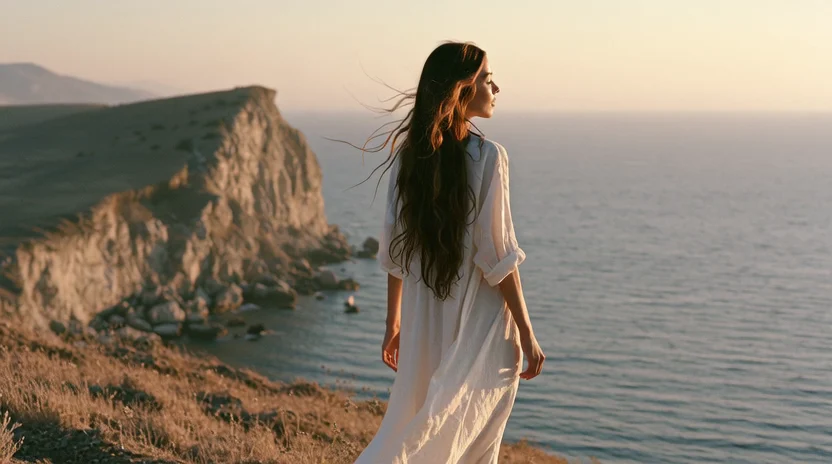
3,4 с
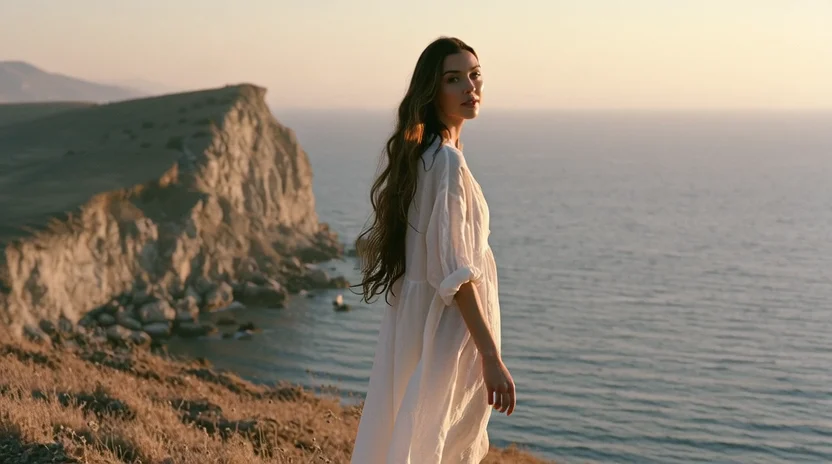
5,1 с
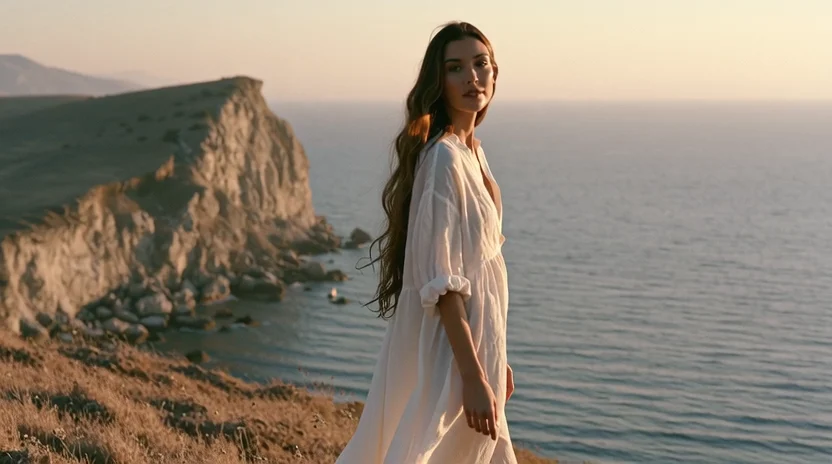
Шаг 1, кадр в Midjourney
young woman standing on a coastal cliff, long hair, linen dress, looking at the sea, golden hour, film photo, wide shot --ar 16:9 --rawШаг 2, Animate → вручную, промпт движения
slow camera dolly in, her hair gently moves in the wind, the light stays the sameОсновные инструменты
| Инструмент | Сильная сторона |
|---|---|
| Google Veo | реалистичное движение, точное следование промпту, синхронный звук в кадре |
| Kuaishou Kling | кинематографичное движение, сильный image-to-video, хорошо сохраняет черты объекта из исходного кадра |
| Runway | не только генерация, а полноценная продакшн-среда с инструментами редактирования и итерации |
| Luma (Ray) | кинематографичная работа с движением через ключевые кадры (keyframe workflow) |
| ByteDance Seedance / Alibaba Wan | Seedance — мультишот (Dreamina, Runway); обе — API-пайплайны для продакшена, Wan 2.x ещё и локально |
| Grok Imagine (xAI) | image-to-video с сильным сохранением исходного кадра (композиция, объекты), встроенная генерация звука в том же проходе |
| Midjourney (Video, кнопка «Animate») | оживление собственного или загруженного изображения прямо в интерфейсе Midjourney, без ухода в отдельный инструмент; заметно дешевле специализированных видео-моделей |
С июня 2025 у Midjourney есть собственное нативное видео. Раньше для оживления midjourney-кадра приходилось уходить в отдельный инструмент (Kling, Runway), теперь есть кнопка Animate прямо там же. Она генерирует ролик в 5 секунд, с продлением по 4 секунды до 21, в автоматическом режиме (модель сама выбирает движение) или в ручном (свой промпт на движение). Результат можно продлевать до 21 секунды. Для дизайнера это самый низкий порог входа в оживление собственных генераций: не нужен даже переход на другой сайт.
Внутри Runway не одна модель, а несколько под разные задачи одной продакшн-среды. Актуальное поколение генерации видео из текста и изображения — семейство Gen-4 / Gen-4.5 на момент подготовки материала. Act-One и его преемник Act-Two — отдельная линейка моделей, которая переносит мимику и актёрскую игру с видео реального человека на сгенерированного персонажа, без риг и захвата движения. Видео-референс с реальным человеком — только своё или с его согласия, как и с аватарами ниже. Aleph — редактирование и трансформация уже готового видео по текстовому промпту (video-to-video: поменять освещение сцены, стиль, время суток), а не генерация с нуля. Конкретные названия и возможности сверяй прямо в интерфейсе Runway в момент использования. Это один из инструментов, который обновляется особенно часто.
ByteDance Seedance и Alibaba Wan заслуживают отдельного слова, а не только строки в таблице. Мультишотовая генерация — это когда модель за один проход выдаёт сразу несколько связанных кадров (например, три ракурса одной сцены) и сохраняет персонажа, свет и палитру согласованными между ними. Без этого пришлось бы генерировать каждый кадр отдельно и вручную сводить их в единый стиль, как в сториборд-пайплайне ниже. Мультишот умеют Seedance и Kling 3.0. Seedance доступен в веб-приложении Dreamina (dreamina.capcut.com), а с мая 2026 — и внутри Runway. Wan 3.0 работает через API Alibaba Cloud, а Wan 2.x можно запустить локально: веса открыты, есть сборки для ComfyUI. Через API обе модели удобны для батча, когда нужно не «сгенерировать один ролик сегодня», а «сто вариаций подряд по каталогу»: например, промо-видео под каждую позицию товаров, а не один герой-ролик. Это тот же принцип batch-обработки, что и в теме «Продакшн-процессы и передача результатов», только применённый к видео.
Куда вставлять такой промпт: в Kling 3.0, где мультишот есть прямо в веб-интерфейсе и длину каждого кадра можно задать отдельно, или в Seedance — в Dreamina или в Runway. В обычном image-to-video он сработает как описание одного кадра.
Сгенерируй мультишотовую последовательность из 3 связанных кадров для промо флакона духов: кадр 1 — флакон крупным планом на мраморной поверхности, кадр 2 — та же сцена, камера медленно отъезжает и показывает весь стол с цветами, кадр 3 — рука в кадре берёт флакон со стола. Сохрани одинаковое освещение, цветовую палитру и материал поверхности во всех трёх кадрах
Кадр 1, общий план
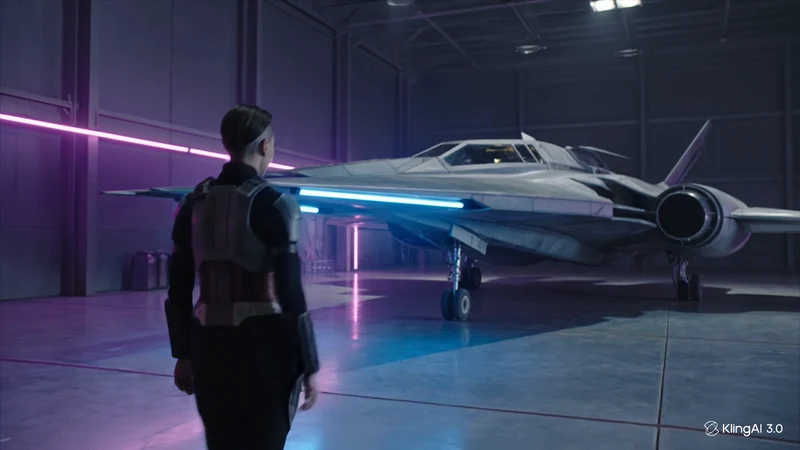
Кадр 2, крупный план
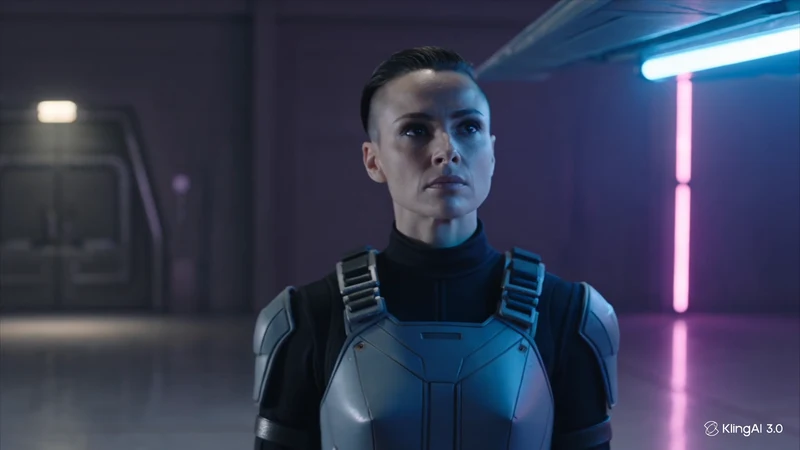
Кадр 3, деталь
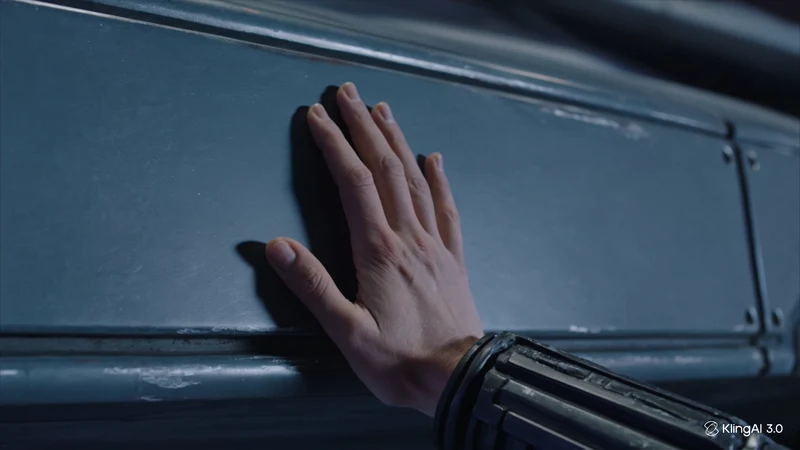
Отдельная судьба у OpenAI Sora, поэтому её нет в таблице выше. Потребительское приложение и сайт sora.com закрылись 26 апреля 2026, а доступ через API отключён 24 сентября 2026. Продукта в прежнем виде больше не существует. Если OpenAI когда-нибудь вернётся к видео под этим или другим именем, это будет уже новый запуск, а не продолжение старого. Общий урок для всей темы — в привычке, а не в конкретной модели. Видео-модели меняются даже быстрее, чем текстовые и картиночные. Список инструментов и их статус сверяй с актуальным состоянием рынка, а не со снимком на момент написания материала.
Когда результат не тот: как поправить, а не переснимать с нуля
Здесь главное отличие от темы «Генерация изображений». Большинство видео-моделей не умеют продолжать разговор так же надёжно, как GPT Image или Nano Banana. Попытка «поправить» уже сгенерированное видео новым промптом чаще всего запускает новую генерацию с нуля, а не точечную правку. Из этого следует практическая стратегия:
- Чинить исходный кадр, а не движение. Если оживлённое видео получилось не то, почти всегда быстрее и надёжнее вернуться на шаг назад. Поправь исходное статичное изображение (тема «Редактирование изображений и ретушь», раздел «Редактирование и правки») и оживи уже исправленный кадр заново. Донастраивать готовое видео текстом дольше и ненадёжнее.
- Редактировать готовое видео — отдельный инструмент, а не текстовый повтор. Если нужно именно поправить уже смонтированный ролик (сменить время суток, освещение, стиль), а не переделывать движение, для этого есть Runway Aleph (см. выше). Это video-to-video редактирование, а не повторная генерация с нуля.
- Фиксировать seed при повторных попытках. Так же, как и с изображениями (тема «Генерация изображений», раздел «Ключевые техники»), фиксация seed при повторной генерации даёт более предсказуемый, сравнимый результат. Поле seed есть не везде: в Runway и при работе через API оно доступно, а во многих веб-интерфейсах его нет. Это полезно, когда правится не всё видео целиком, а один конкретный параметр движения или композиции.
- Использовать keyframe-инструменты для управления траекторией. Luma (Ray) и похожие инструменты с keyframe-воркфлоу позволяют явно задать начальный и конечный кадр движения. Модели не приходится угадывать правильную траекторию между ними с первого раза, и неудачных попыток становится меньше, чем в чистом text-to-video.
- Тестировать на коротких и дешёвых сегментах перед финальным рендером. Видео-генерация стоит денег (раздел ниже). Поэтому сначала прогони 2–3 секунды в низком качестве, чтобы проверить композицию и движение камеры, и только потом генерируй финальную, более длинную и дорогую версию. Получить готовый ролик с первой попытки удаётся редко, и это нормально.
Сколько это стоит
Видео — заметно более дорогая генерация, чем картинка или текст. Одна секунда видео в среднем требует на порядки больше вычислений, чем одно изображение, и это напрямую отражается в тарифах. У популярных инструментов встречаются три модели биллинга:
- Кредиты внутри подписки (Runway, Luma). Платишь за месячный пакет кредитов, каждая генерация списывает часть пакета в зависимости от длины и качества ролика. Кончились кредиты — жди сброса лимита или доплачивай.
- Оплата за секунду сгенерированного видео (частая модель для Kling, Veo при доступе через API). Чем длиннее и качественнее ролик, тем прямо пропорционально дороже. При таком биллинге особенно оправдан сториборд-пайплайн ниже: сгенерировать 5 коротких, точно нацеленных шотов дешевле, чем несколько раз переснимать один длинный ролик.
- Бесплатный лимит с ограничениями. Почти у всех инструментов есть бесплатный тариф, но часто с водяным знаком, ограничением по разрешению или длительности и меньшим приоритетом в очереди генерации.
Конкретные цифры устаревают быстрее, чем что-либо ещё в этой области, поэтому таблицы с числами здесь принципиально нет. Сверяй их в моменте на сайте конкретного инструмента. Но сам порядок величины держи в голове: если генерация изображения обычно стоит центы, то одна короткая видео-генерация может стоить уже доллары. Закладывай это в бюджет проекта на этапе брифа (тема «Брифы с ИИ»), а не постфактум.
Говорящие аватары и lip-sync
Отдельная, очень частая для дизайнера задача — сделать говорящего человека на видео, а не оживить сцену: обучающий ролик, короткая презентация от лица бренда, локализация уже готового видео на другой язык. Здесь работает другой класс инструментов — специализированные сервисы для говорящих аватаров. HeyGen и Synthesia — два самых известных. Оба дают выбрать аватара (готового или созданного по видео реального человека), вставить текст или аудиодорожку и получить видео, где аватар произносит текст с синхронизацией губ (lip-sync) под звук.
Практический сценарий выглядит так. Сначала пишется текст (тема «Написание контента и UX-текстов»). Если нужно, он озвучивается через TTS (тема «Генерация голоса и аудио»). Затем готовая аудиодорожка или текст загружается в HeyGen/Synthesia для синхронизации с видео аватара. То есть это финальный шаг в цепочке, а не замена остальным инструментам темы.
Здесь особенно остро встаёт то же правило, что и с клонированием голоса (тема «Генерация голоса и аудио»). Создавать говорящего аватара по видео реального человека — сотрудника компании, публичной персоны, случайного человека — можно только с его явным согласием. Именно поэтому большинство инструментов требуют загрузить видео-подтверждение согласия перед созданием кастомного аватара.
Управление камерой
В промпт для видео закладывай не только «что происходит», но и «как двигается камера». Это отдельный словарь, знакомый дизайнерам по операторской работе:
- dolly in / dolly out — камера физически приближается/отдаляется;
- pan left / pan right — камера поворачивается по горизонтали, оставаясь на месте;
- orbit — камера облетает объект по дуге;
- static shot — камера полностью неподвижна;
- handheld — лёгкое естественное дрожание, «ручная камера»;
- aerial / drone shot — вид сверху, будто с дрона;
- close-up / wide shot — крупный и общий план.
Motion Control: перенос движения с референсного видео
Это отдельный сценарий, не похожий на обычную анимацию кадра. Здесь ты не «оживляешь статичное изображение своим движением», а переносишь на него конкретное, уже существующее движение: реальную жестикуляцию, мимику, походку с видео-референса. Kling Motion Control — пример такого инструмента. На вход подаётся статичное изображение персонажа и референсное видео с нужным движением. На выходе персонаж с изображения повторяет именно это движение и мимику, сохраняя собственные черты лица и внешность. Отличие от обычного image-to-video: там модель сама придумывает движение по текстовому описанию, здесь движение задаётся буквально, кадр за кадром, референсным видео.
Практическое применение для дизайнера: оживить иллюстрированного или сгенерированного персонажа бренда конкретным, заранее срежиссированным жестом (кивок, приветственный жест, поворот к камере). Сыграть движение самому или найти его на видео-референсе быстрее и предсказуемее (видео-референс с реальным человеком — только своё или с его согласия, как и с аватарами ниже), чем подбирать словесное описание, которое модель поймёт правильно с первой попытки.
Перенос задаётся режимом и загрузкой файлов, а не текстом:
- Выбери в Kling режим Motion Control.
- Загрузи изображение персонажа.
- Загрузи референсное видео с движением длиной 3–30 секунд. В нём должен быть один человек, видный в кадре целиком.
- Промпт описывает сцену и стиль, а не движение — движение берётся из видео.
Сториборд-пайплайн для кампании
Ролик редко получается одним промптом. Его собирают из нескольких коротких кадров (шотов): каждый генерируется и оживляется отдельно, а затем всё монтируется вместе:
- Разбей сценарий на 3–5 кадров-шотов, для каждого опиши композицию.
- Сгенерируй статичное изображение для каждого шота (тема «Генерация изображений»), добиваясь консистентного стиля через стайл-гайд.
- Оживи каждый кадр по отдельности через image-to-video с нужным движением камеры.
- Смонтируй шоты вместе в любом видеоредакторе (или попроси сам инструмент, если он это умеет, собрать черновой монтаж).
- Добавь звук. Саундтрек, звуковые эффекты или войсовер (тема «Генерация голоса и аудио») почти никогда не создаются в том же инструменте, что и сам ролик. Этот шаг легко забыть. А немой черновик и готовый ролик со звуком воспринимаются совершенно по-разному, даже если картинка не поменялась ни на кадр.
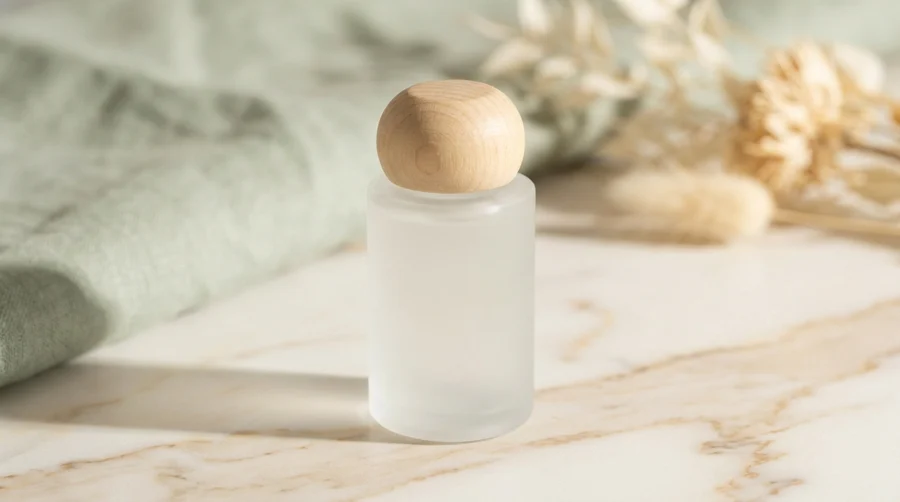
Кадр 1: флакон на мраморе
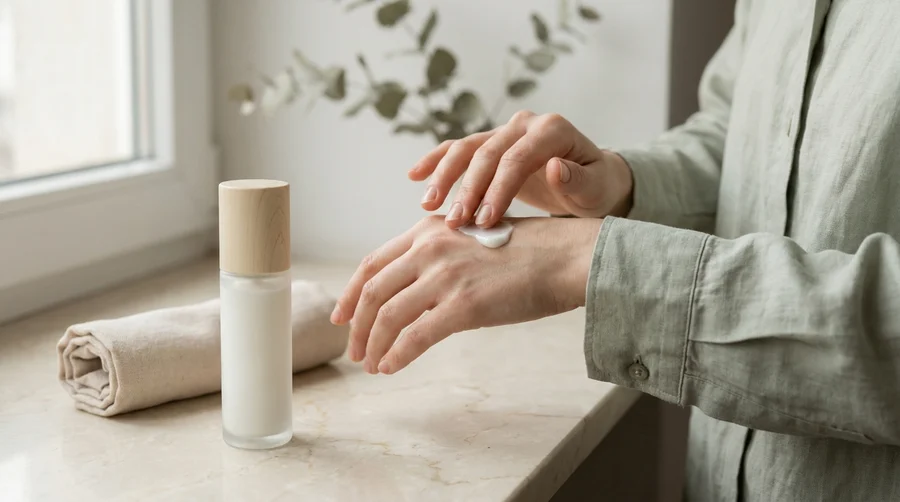
Кадр 2: руки наносят продукт
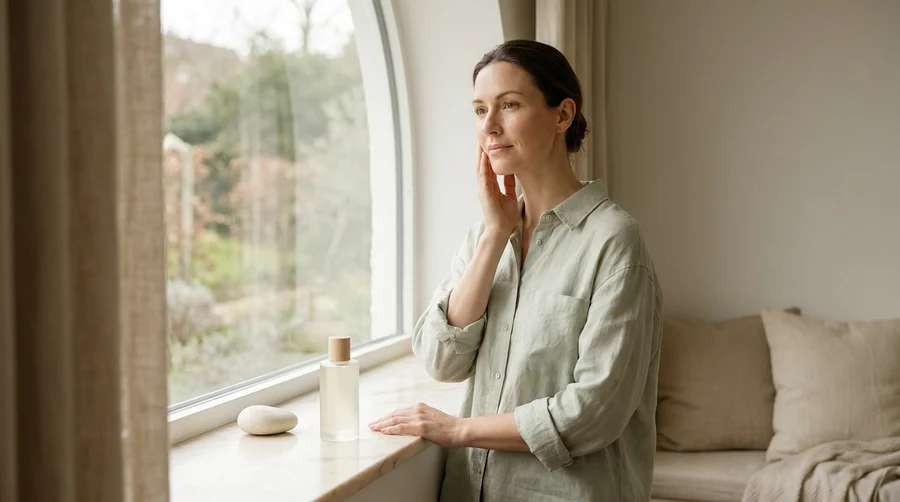
Кадр 3: модель у окна
Photorealistic photograph. Commercial campaign still for an eco skincare brand: soft natural light, warm white marble, pale sage and sand palette, calm minimal composition, shallow depth of field, 16:9 cinematic frame. [Shot 1: close-up of an unlabeled frosted glass skincare bottle with a wooden cap standing on a white marble surface.]Примеры промптов
Оживи это изображение: медленное движение камеры вперёд (dolly in), лёгкое покачивание волос от ветра, свет не меняетсяКинематографичный кадр: дрон облетает современное здание на закате, тёплый свет, плавное движение камерыДлительность и формат кадра в обоих случаях выставляются переключателями в интерфейсе, а не словами в промпте. Сколько секунд доступно, зависит от модели и тарифа: у Kling 3.0, например, до 15 секунд на генерацию.
Собери сториборд из 4 кадров для 15-секундного рекламного ролика бренда экокосметики: кадр 1 — крупный план флакона на мраморном фоне, кадр 2 — руки наносят продукт, кадр 3 — модель у окна в естественном свете, кадр 4 — логотип и слоган на пастельном фоне. Для каждого кадра опиши движение камерыУ меня есть эта иллюстрация героя лендинга (вставить). Напиши промпт для Kling, чтобы оживить её с лёгким параллаксом и покачиванием элементов, без резких движенийНе то движение волос и слишком резкий наезд камеры — вот исходное изображение (вставить): поправь позу и освещение в нём, остальное не трогай — дальше я заново оживлю этот кадр с более медленным dolly inВот уже смонтированный клип (вставить) — поменяй время суток на закат, добавь тёплый свет, остальную композицию и движение не трогайВот текст для 30-секундного обучающего ролика (вставить). Подготовь его к озвучке: разбей на короткие фразы с паузами, отметь интонационные акценты и места, где диктору нужно замедлиться. Голос будет дружелюбный и спокойный, аватар — в деловом повседневном образеСобери мини-набор из 3 роликов для одной воображаемой кампании (hero-кадр, деталь продукта, lifestyle-сцена). Все три — из одного стайл-гайда и с последовательным, а не случайным движением камеры между кадрами.
Источники
- Introducing Our V1 Video Modelupdates.midjourney.com
Видео в Midjourney с июня 2025: кнопка Animate, 5 секунд и продления
- Kling VIDEO 3.0 Model Guidekling.ai
Kling 3.0: до 15 секунд и мультишот с длиной каждого кадра
- Kling Motion Control User Guidekling.ai
Требования к референсному видео: 3–30 секунд, один человек целиком
- Runway API Changelogdocs.dev.runwayml.com
Даты появления Gen-4.5, Aleph, Act-Two и Seedance в Runway
- Veodeepmind.google
Veo 3.1 генерирует синхронный звук
- Recording your Consent Videohelp.heygen.com
HeyGen требует видео-согласие для каждого аватара по видео
Нашёл ошибку или устаревший факт? Напиши: hey@iskra.guide