Генерация голоса и аудио
Голос — последний из основных медиаформатов, которым дизайнер сегодня управляет наравне с картинкой, видео и текстом. Озвучка для презентации клиенту, войсовер для промо-ролика (тема «Генерация и монтаж видео»), голос для прототипа голосового интерфейса, быстрая транскрипция созвона в текст брифа. Инструментов здесь много, но осваивать все не нужно. Важно понять, какая задача под какой тип генерации, и этого хватит.
Text-to-speech (TTS): текст → голос
Text-to-speech превращает написанный текст в озвучку заданным голосом. Голос может быть стандартным из библиотеки инструмента или клонированным под конкретного человека (см. ниже про этику). Типовой сценарий для дизайнера — озвучить сценарий ролика или закадровый текст в презентации, не нанимая диктора ради одной черновой версии.
Здесь легко ошибиться с тем, что писать в поле. В ElevenLabs и большинстве TTS-сервисов всё, что вставлено в поле текста, будет прочитано вслух. Фраза «озвучь голосом уверенного диктора» прозвучит в ролике дословно. Поэтому разделяй две вещи: что читать — это сам текст, и как читать — это голос, ползунки и теги. Манеру задают выбором голоса, настройками стабильности и стиля, тегами эмоций и паузами. Словесные указания вроде «уверенно, спокойно, средний темп, без драматизации» понимают TTS внутри Gemini и OpenAI, и там их пишут отдельной инструкцией, а не в тексте озвучки. Выставляй манеру явно: на настройках по умолчанию результат звучит монотонно.
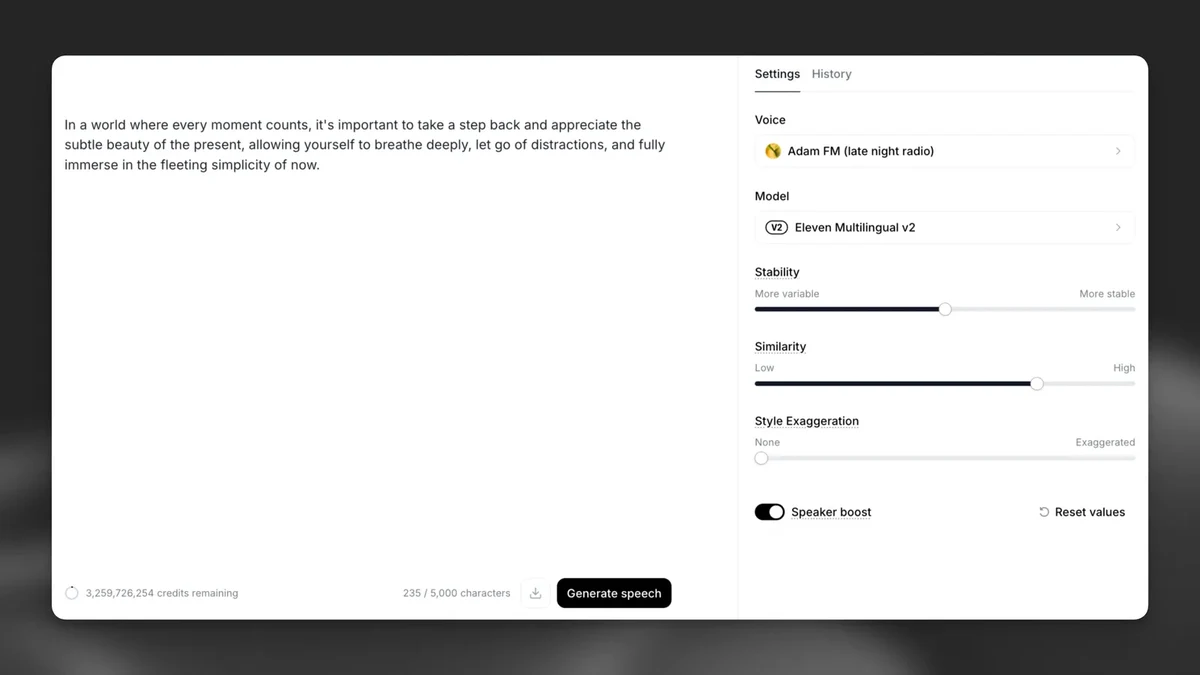
ElevenLabs — самый известный инструмент для TTS и клонирования голоса. Большая библиотека готовых голосов на разных языках, тонкая настройка эмоций и темпа, один из самых качественных движков для клонирования (см. ниже про этику). Клонирование голоса доступно только на платных тарифах. Помимо ElevenLabs, TTS сегодня встроен и в обычные текстовые модели. Gemini умеет прочитать свой ответ вслух по кнопке Listen, а у Claude это только через голосовой режим. Для быстрого черновика этого часто достаточно.
Голосовой режим: разговор с моделью в реальном времени
Отдельно от TTS и STT полезно знать про голосовой режим (voice mode). Это функция в приложениях ChatGPT, Gemini и Claude, где с моделью можно говорить вслух и получать голосовой ответ в реальном времени, как в телефонном разговоре. Отдельных шагов «наговорил → дождался расшифровки → прочитал ответ → озвучил его» нет. Для дизайнера это удобный способ быстро надиктовать идею на ходу или обсудить бриф голосом вместо печати. Как инструмент финальной генерации он не подходит: результат такого разговора обычно нужно потом оформить текстом отдельно.
Speech-to-text: голос → текст
Обратная задача — транскрипция. Записанный созвон с клиентом, голосовая заметка с идеей, аудиоверсия брифа превращаются в текст, с которым уже можно работать как с любым другим материалом (тема «Написание контента и UX-текстов», тема «Брифы с ИИ»). Аудиофайл прямо в чате надёжно принимают Gemini и Gemini Notebook (бывший NotebookLM). Длинные записи для ChatGPT надёжнее сначала превратить в текст, а Claude аудио не принимает вовсе. Для них путь другой: сначала транскрипт (Otter, Granola, Descript, Whisper), потом текст в чат. Gemini и Gemini Notebook способны не просто транскрибировать, а сразу структурировать сказанное: например, вытащить из записи созвона список вопросов клиента или структуру брифа, а не только дословный текст.
Для регулярных созвонов удобнее не вставлять файл в чат вручную каждый раз, а взять специализированный инструмент, который делает это автоматически. Otter, Fireflies и Granola — самые распространённые сервисы для транскрипции и суммаризации созвонов. Otter и Fireflies подключаются к Zoom и Google Meet ботом-участником, а Granola записывает системный звук прямо на компьютере, без бота. Для приватности это разные вещи: бота видят все участники звонка. Все три сами отдают текст встречи, краткое резюме и список задач сразу после звонка.
Отдельная, более новая категория — носимые устройства для захвата разговора. Omi и Plaud — компактные гаджеты (кулон или накладка на телефон), которые непрерывно или по кнопке записывают разговор вокруг тебя в течение дня. Не только звонки за компьютером, а любые встречи, кофе с клиентом, случайную идею вслух. Смысл этого класса устройств не в самой записи, а в том, что происходит дальше. Собранное аудио автоматически расшифровывается, из него вытаскиваются задачи и заметки, и всё это можно передавать в другие инструменты: в свою систему заметок или в тот же ИИ-чат для брифа (тема «Брифы с ИИ»). Для дизайнера это практично на клиентских встречах и воркшопах, где неудобно параллельно печатать. Устройство фиксирует сказанное, а структурирование в текст происходит уже после.
Редактирование аудио и видео через текст
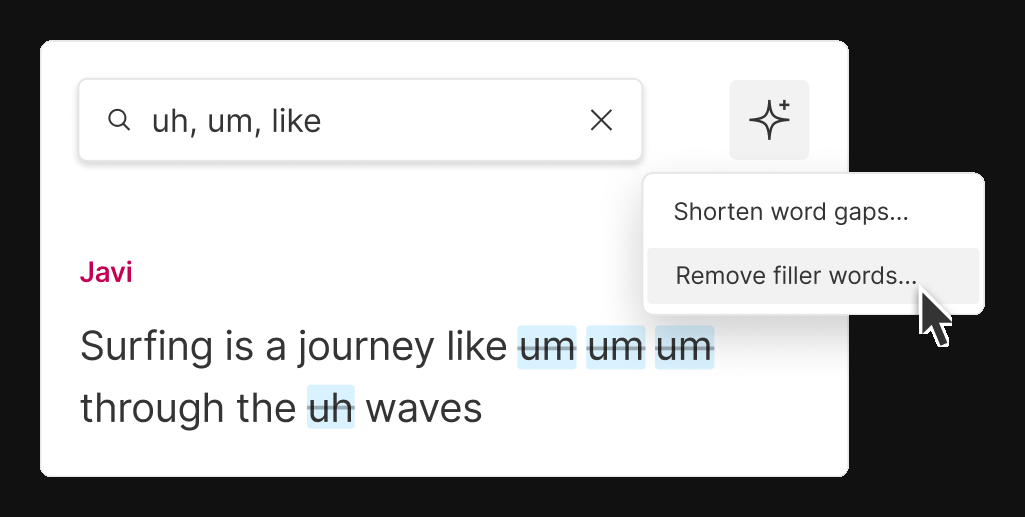
Удобный побочный эффект хорошей транскрипции: саму запись можно редактировать, редактируя её текст. Descript — самый известный инструмент этого класса. Загружаешь аудио или видео, получаешь транскрипт, а дальше правишь запись буквально как документ Word. Удаляешь слово-паразит в тексте — и оно вырезается из звука или видео вместе с соответствующим фрагментом. Переставляешь абзацы текстом — переставляется и монтаж. Для дизайнера это особенно полезно при доводке войсовера или интервью для кейс-стади в портфолио (тема «Портфолио»). Чтобы вычистить запинки и паузы из уже записанного материала, монтировать звук покадрово уметь не нужно.
Клонирование голоса и этика
Отдельная, более деликатная категория — voice cloning: инструмент воспроизводит конкретный, реальный голос человека по короткому образцу записи. Возможность мощная: например, дать голос бренду один раз и переиспользовать его во всех роликах. Но она прямо пересекается с темой «Этика, приватность и ограничения». Клонировать голос реального человека без его явного согласия — риск не только репутационный, но и юридический в большинстве юрисдикций, независимо от того, был ли злой умысел. Для брендовых и клиентских проектов правило простое. Клонировать можно только голос, на который есть явное разрешение: сотрудник компании, актёр озвучки, подписавший релиз. Голос публичной персоны или случайного человека без согласия — никогда, даже в шутку или в тестовом прогоне.
Генерация музыки: Suno и другие
Это более крупная категория, чем короткие звуковые эффекты ниже: генерация полноценных музыкальных треков с нуля. Suno — самый известный инструмент. Он принимает текстовый промпт (жанр, настроение, при желании — текст песни) и отдаёт готовый трек с вокалом и инструменталом за один запрос. Его давний конкурент Udio — показательная история о том, как быстро здесь меняются правила. После мировых соглашений с крупными лейблами в конце 2025 года сервис отключил скачивание треков и перестраивается в закрытую лицензионную платформу, где музыка остаётся внутри сервиса. Suno пошёл похожим путём мягче: с 3 сентября 2026 скачивания лимитированы. На бесплатном тарифе — 7 скачиваний за всё время аккаунта и только для личного некоммерческого использования, на Pro — 20 в месяц, на Premier — 60. Для рабочих задач это принципиально: прежде чем строить на инструменте процесс, проверь, можно ли вообще забрать из него файл. Для дизайнера генерация музыки чаще всего сводится к фоновому саундтреку для промо-ролика или презентации. Но полезно знать, что «просто сгенерировать песню под настроение» сегодня требует одного промпта, а не студии и музыканта. Оговорка та же, что и с изображениями. Авторские права на такой трек и возможность его коммерческого использования у разных сервисов и в разных юрисдикциях устроены по-разному. Перед использованием в клиентском проекте уточни это в условиях конкретного сервиса (см. тему «Этика, приватность и ограничения»).
Аудио-реактивные и звуковые эффекты
Смежная, но более мелкая по масштабу категория — генерация коротких звуковых эффектов под конкретное действие в интерфейсе или сцене: звук клика, уведомления, перехода между экранами. Это отдельный класс инструментов, не TTS и не генерация музыки. В промпте для него описывают не слова, а настроение и характер звука: «короткий, минималистичный звук уведомления, мягкий, не резкий, электронный, длительность 0.5 секунды».
Сколько это стоит
Как и с видео (тема «Генерация и монтаж видео с ИИ»), голос и музыка обычно тарифицируются не так, как текст. TTS чаще всего считается по количеству озвученных символов или минут в месяц (у ElevenLabs — пакет кредитов, примерно по кредиту за символ, на тарифе). Клонирование голоса и генерация музыки — по числу генераций или минут готового аудио. Конкретные цифры устаревают быстро, поэтому здесь их намеренно нет. Но сам принцип держи в голове при планировании бюджета проекта (тема «Брифы с ИИ»): чем длиннее аудио и чем больше голосов и треков нужно, тем ощутимее это скажется на тарифе. Закладывай это заранее, чтобы не увидеть постфактум в счёте.
Отдельно про говорящих аватаров и синхронизацию озвучки с видео (lip-sync) — HeyGen, Synthesia — см. тему «Генерация и монтаж видео с ИИ». Это следующий шаг после того, как голос уже готов здесь.
Примеры команд для практики
Вот сценарий войсовера для 20-секундного ролика (вставить текст) — раздели его на короткие фразы с паузами так, чтобы озвучка звучала естественно, а не скороговоркойВот транскрипт созвона с клиентом (вставить текст или приложить .txt). Собери из него структурированный бриф: цель, аудитория, референсы, ограничения. Всё, что осталось неясным, вынеси отдельным списком вопросов — не заполняй пробелы догадкамиПридумай короткое текстовое описание фонового звука для уведомления об успешной оплате в приложении: спокойный, короткий, не раздражающийОбъясни простыми словами разницу между TTS-голосом из стандартной библиотеки и клонированным голосом — и какие у клонирования есть этические ограниченияВот аудиозапись созвона с клиентом (приложить файл). Сделай из неё структурированный бриф: цель, аудитория, референсы, ограничения. Всё, что осталось неясным, вынеси отдельным списком вопросовСпокойный минималистичный трек для фона презентации, электроника с лёгким акустическим элементом, ровная динамика без резких подъёмовВокал выключается переключателем Instrumental. Длина задаётся не промптом, а ползунком Duration в Custom mode (появился в v5.5); в авто-режиме Suno выбирает длину сам. Точную секунду ползунок не гарантирует, а обрыв на заданной длине бывает резким — фейд делай в монтаже.
Вот транскрипт клиентской встречи из Granola (вставить) — вытащи из него только принятые решения и открытые вопросы, без пересказа всего разговораВот транскрипт интервью для кейса в портфолио, экспортированный из Descript (вставить текст). Отметь фразы-паразиты и повторы, которые можно вырезать без потери смысла, — списком цитатПаузы в тексте не видны, их Descript убирает сам встроенной функцией удаления пауз.
Озвучь один короткий текст (например, черновой войсовер для ролика из темы «Генерация и монтаж видео») двумя разными голосами или интонациями из одного инструмента. Послушай, насколько сильно голос меняет восприятие одного и того же текста.
Источники
- An update to our downloads policy and Terms of Servicesuno.com
Лимиты скачиваний в Suno с 3 сентября 2026 по тарифам
- Changes associated with the Universal Music Group partnershiphelp.udio.com
Udio отключил скачивание аудио, видео и стемов
- ElevenLabs Pricingelevenlabs.io
Клонирование голоса с тарифа Starter, расход кредитов на символ
- Upload files to Claudesupport.claude.com
Claude принимает документы и изображения, аудио и видео нет
- Use voice modesupport.claude.com
Голосовой режим Claude на всех планах
- NotebookLM is now Gemini Notebookblog.google
С 16 июля 2026 NotebookLM называется Gemini Notebook
Нашёл ошибку или устаревший факт? Напиши: hey@iskra.guide