Оценка и критика результатов ИИ
ИИ выдаёт результат быстро, но не всегда хорошо. А «нравится / не нравится» для рабочего процесса — слабый критерий: по нему трудно объяснить, что именно не так и что менять. В этой теме ты научишься оценивать вывод ИИ по конкретным критериям, а не только по интуиции. Для этого хватит чек-листа и второй модели в роли критика.
Чек-листы оценки по типу вывода
Визуал: композиция и баланс, соответствие бренд-гайду, технические огрехи (лишние пальцы, искажённые пропорции, нечитаемый текст), готовность к продакшену без ручной доработки.
Текст: фактическая точность (см. тему «Поиск и ресерч контента»), соответствие тону бренда, длина и формат, отсутствие повторов и «воды».
Код/прототип: реально ли работает, а не только выглядит рабочим; обработаны ли крайние случаи (пустые состояния, ошибки ввода); доступность; соответствие исходному макету.
Эвристическая оценка с помощью ИИ
Попроси модель оценить результат, свой или чужой, по формальному чек-листу. Например, по 10 эвристикам юзабилити Якоба Нильсена для интерфейсов или по внутреннему бренд-гайду компании. Так субъективное «что-то не так» превращается в конкретный список нарушений с объяснением. Как применять это к рабочим макетам каждый день (ревью, состояния, доступность), рассказано в теме «ИИ в работе над макетом».
Кросс-модельная валидация
Полезный приём: показывать результат другой модели, а не той, что его создала. У каждой модели свои «слепые пятна», и свою работу она склонна хвалить. Взгляд со стороны получается объективнее.
В вайбкодинг-проекте тот же принцип масштабируется дальше одного критика. Вместо единственного промпта «придирчивый арт-директор» из примеров ниже можно завести несколько параллельных сабагентов-персонажей, у каждого своя узкая роль. Подробный разбор с готовым промптом есть в теме «Терминальные агенты: настройка под себя».
Один пример целиком: от «что-то не так» к списку правок
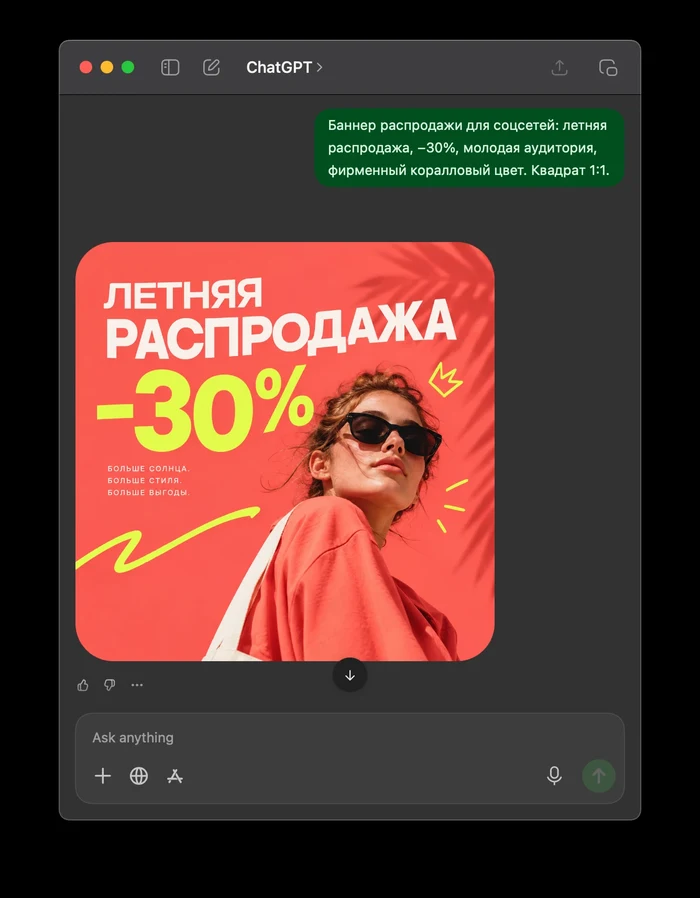
Чтобы чек-лист не остался абстракцией, вот один проход на реальной задаче. Дано: баннер распродажи для соцсетей, сгенерированный в GPT Image по брифу «летняя распродажа, −30%, молодая аудитория, фирменный коралловый цвет». На глаз он «вроде нормальный, но что-то не то». Вместо «оцени баннер» другой модели (не той, что генерировала) уходит рубрика:
Оцени этот баннер по пяти критериям, каждый от 1 до 5, к каждой оценке — одно предложение с конкретикой:
1. Соответствие брифу (вставить бриф)
2. Читаемость главного сообщения за 2 секунды
3. Техническое качество: артефакты, текст, края объектов
4. Соответствие бренду: цвет похож на фирменный коралловый (точное значение я проверю пипеткой), шрифт без засечек, без градиентов
5. Готовность к публикации без доработки
Затем дай список правок по убыванию важности. Для каждой правки укажи, насколько ты уверен, и что мне стоит перепроверить самому.
Ответ Gemini в сокращении:
1. Бриф — 4/5. Лето, молодая героиня, крупная скидка и коралловый фон попадают в задачу.
2. Читаемость — 5/5. Белый и неоново-жёлтый на плотном фоне считываются мгновенно.
3. Техника — 1/5. Буква «Ж» сломана, в знаке процента три кружка, мелкий текст — нечитаемая псевдокириллица, на оправе очков лишний кусок пластика.
4. Бренд — 4/5. Шрифт без засечек, градиентов нет, только тени листьев; цвет похож на фирменный, но нужна сверка.
5. Готовность — 1/5.
Правки: (1) переверстать весь текст фирменным шрифтом; (2) убрать артефакт на очках; (3) сверить фон пипеткой с #FF6B5E; (4) перерисовать или убрать корону и линии.
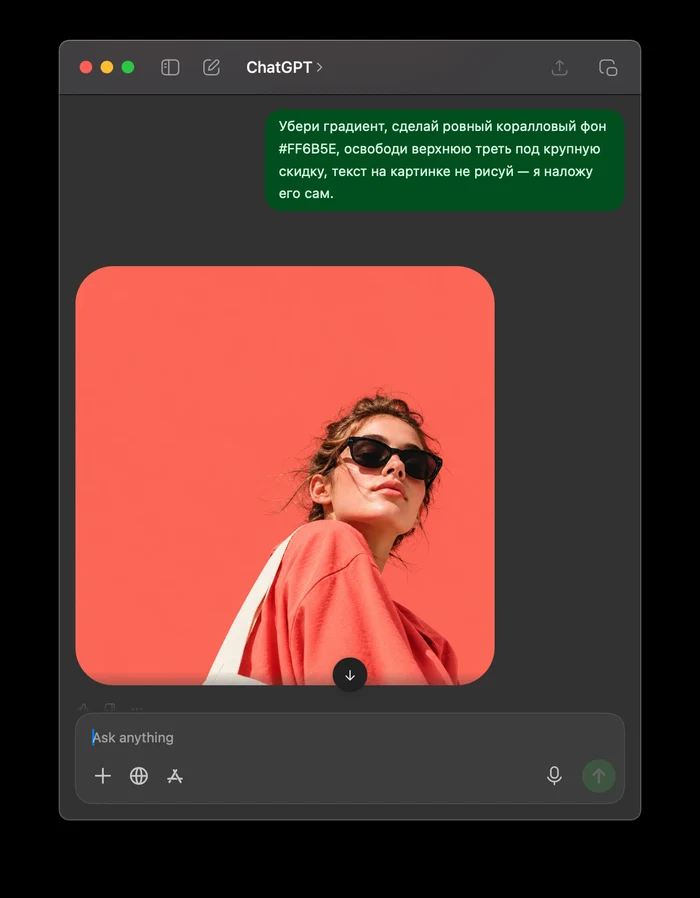
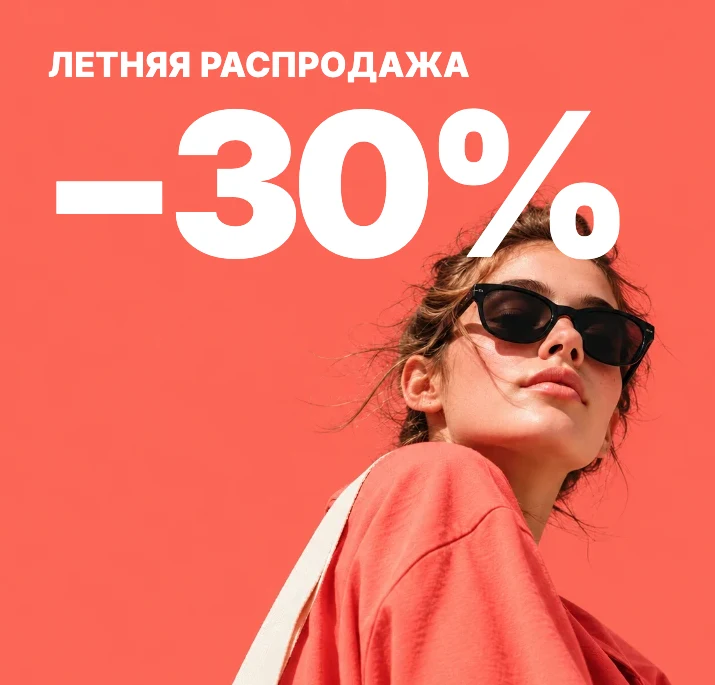
Главное в примере — что с этим списком делает дизайнер. Сначала каждое замечание проверяется на увеличенной картинке. «Ж» целая, процент обычный, мелкий текст читается, очки без нароста. Половина пункта 3 и вся правка 2 — ложная тревога: модель знает, какие артефакты бывают у генераций, и «нашла» их по привычке. Правка 3 подтверждается пипеткой: фон #F95B51 вместо #FF6B5E, близко, но темнее. Правка 4 принимается, а к ней добавляется то, что модель пропустила: салатовая скидка тоже не из бренда. Правка 1 принимается, но по другой причине: текст, наложенный вёрсткой, можно поправить за минуту, а сгенерированный — только перегенерацией. Итог за десять минут: три правки, одна отклонённая и одна найденная самим. Оценка модели — это черновик ревью. Решение остаётся за тобой.
По брифу
После правок в том же чате
Текст наложен вёрсткой
Шаг 1, бриф
Баннер распродажи для соцсетей: летняя распродажа, −30%, молодая аудитория, фирменный коралловый цвет. Квадрат 1:1.Шаг 2, правка в том же чате
Убери градиент, сделай ровный коралловый фон #FF6B5E, освободи верхнюю треть под крупную скидку, текст на картинке не рисуй — я наложу его сам.Чего модель на картинке не видит
Мультимодальные модели хорошо считывают композицию, иерархию, смысл и явные артефакты. А вот с тем, что требует измерения, они справляются плохо. Знай это заранее, чтобы не доверять модели там, где ей доверять нельзя:
- Пиксельная точность. Отступ 12 или 16, сбитое на 2 пикселя выравнивание, разная толщина линий: по скриншоту модель этого надёжно не определит, хотя уверенно назовёт цифру. Для таких вещей есть линейки, плагины и Figma MCP, который отдаёт реальные значения (тема «Вайбкодинг: интерфейсы»). Для MCP нужно Dev- или Full-место на платном плане Figma: на бесплатном лимит запросов символический.
- Точный цвет и контраст. Оттенок и тем более коэффициент контраста модель оценивает на глаз. Контраст по WCAG нужно считать инструментом, а не мнением.
- Мелкий текст. На скриншоте низкого разрешения модель не читает мелкий текст, а достраивает его по смыслу. Она может «увидеть» опечатку, которой нет, или пропустить настоящую.
- Поведение. По статичному экрану не видно ховеров, анимаций, скорости отклика и того, что происходит при ошибке.
Отдельная проблема — льстивость. На вопрос «хорошо ли это» модель охотно отвечает «да, отличная работа» и добавляет пару косметических замечаний. Помогают три приёма: роль критика вместо нейтрального вопроса, требование конкретного числа проблем с сортировкой по важности, и другая модель вместо той, что создавала результат. У этого есть обратная сторона. Если потребовать «найди десять проблем», модель найдёт десять, даже когда настоящих три. Поэтому в рубрике выше есть просьба указать уверенность и то, что лучше перепроверить руками.
Примеры команд
Вот генерация, бриф (вставить) и правила бренд-гайда (вставить или приложить). Оцени её по 4 критериям: соответствие брифу, соответствие бренд-гайду, оригинальность, готовность к продакшену — оценка от 1 до 5 и объяснение. Отдельно перечисли, что по скриншоту проверить нельзя и нужно мерить инструментом: точный цвет, контраст, размерыБез приложенного брифа и гайда модель оценивает соответствие тому, что сама себе придумала.
Проведи эвристическую оценку этого экрана по 10 эвристикам Нильсена, укажи конкретные нарушения с привязкой к элементам интерфейсаТы придирчивый арт-директор с высокими стандартами. Найди всё, что не так с этим изображением, прежде чем я покажу его клиентуЯ сгенерировал этот текст в другой модели (вставить). Проверь его с включённым поиском на фактические ошибки и дай ссылку на источник к каждому проверенному утверждению. Затем сверь тон с памяткой (вставить памятку тона) и отметь повторыБез поиска факты проверяются по памяти модели, а без памятки тона сверять не с чем.
Составь чек-лист QA для этого прототипа перед тем, как показать его команде: что обязательно нужно проверить руками, а не доверять ИИВзять реальный результат, сгенерированный в одной модели, и оценить его в другой по чек-листу из этой темы. Не спрашивать «хорошо ли это», а прогнать по конкретным критериям. Обратить внимание, находит ли вторая модель проблемы, которые пропустила первая. Одно замечание, которое признал справедливым, исправь.
Источники
- 10 Usability Heuristics for User Interface Designnngroup.com
10 эвристик Нильсена
- Understanding SC 1.4.3: Contrast (Minimum)w3.org
контраст 4.5:1 по WCAG
- Rate limits & access — Figma MCP serverdevelopers.figma.com
лимиты Figma MCP на бесплатном и платных планах
Нашёл ошибку или устаревший факт? Напиши: hey@iskra.guide