Фундамент: как устроен промпт и как «думает» ИИ
Это самая базовая тема материала. Её задача — дать понятийный каркас, на который опираются все остальные темы. Терминов здесь много, но каждый введён через практический пример, а не через определение из учебника. Если ты никогда не писал промпты осознанно, начни отсюда: дальше будет проще.
Следующая тема — «Этика, приватность и ограничения». Прочитай её до первого рабочего промпта.
Как «думает» модель: коротко и без математики
Языковая модель не ищет ответ в базе знаний и не «понимает» вопрос так, как человек. Она продолжает текст. Модель получает всё написанное до этого момента и раз за разом предсказывает следующий кусочек — токен. Токен — это часть слова, иногда целое слово или знак (см. глоссарий). Из этого простого механизма следуют четыре практических вывода, на которые опирается весь остальной материал:
- Промпт — это контекст. Модель продолжает то, что ей дали, максимально правдоподобно. Чем точнее задан контекст (роль, аудитория, примеры), тем уже коридор правдоподобных продолжений. Поэтому структура промпта из следующего раздела работает, а «сделай красиво» даёт самое усреднённое из возможного.
- Один и тот же промпт даёт разные ответы. Следующий токен выбирается с долей случайности, а не строго самый вероятный. Степень этой случайности называется температурой. В чат-приложениях её не настроить. В API она есть не у всех моделей: у части актуальных моделей доступно только значение по умолчанию. Подробности по конкретным моделям — в источниках к теме. Это свойство модели, а не поломка. Для брейншторма вариативность полезна. Для повторяемого результата её приходится гасить точным промптом, примерами и фиксированным форматом ответа.
- Модель может уверенно ошибаться. Правдоподобное продолжение и верный ответ — разные вещи. Когда у модели нет нужного знания, она не молчит, а достраивает похожий на правду текст: выдуманную цифру, несуществующую ссылку, неверную дату. Спроси про «правило трёх лисиц» в типографике, и модель может уверенно его объяснить, хотя такого правила нет. Это называется галлюцинацией. Сама модель её никак не помечает, поэтому в теме «Этика, приватность и ограничения» есть правило проверять факты.
- Знания модели заканчиваются на дате обучения. Всё, что случилось позже, она не знает, пока не включён поиск в интернете (тема «Поиск и ресерч контента»). Для быстро меняющихся вещей — версий инструментов, цен, новостей — ответ «по памяти» почти всегда устаревший.
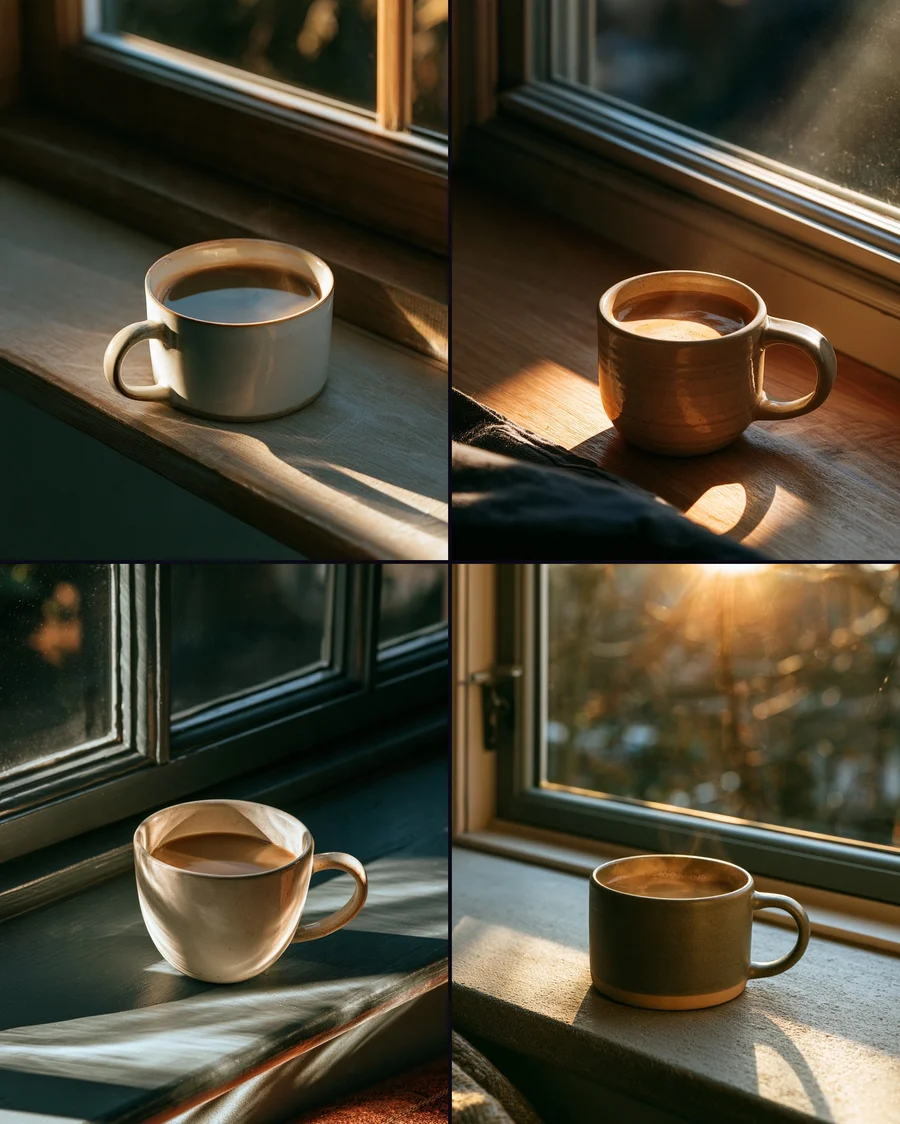
A ceramic mug of coffee on a windowsill, morning light, editorial photo --ar 4:5Анатомия хорошего промпта
Почти любой рабочий промпт — текстовый или для картинки — можно разложить на пять частей. Проверяй себя по этому списку каждый раз, и промпты «одной строкой» уйдут сами собой:
- роль — кем должен «притвориться» ИИ («ты арт-директор», «ты UX-редактор»);
- контекст — что уже известно о задаче, бренде, аудитории;
- задача — что конкретно нужно сделать, желательно одним чётким глаголом;
- формат ответа — список, таблица, JSON, три варианта, максимум 100 слов;
- ограничения — чего делать нельзя: тон, длина, слова-стоп-листы, технические рамки.
У этой раскладки много названий: в англоязычных гайдах встречаются RTF, RACE и CO-STAR. Суть одна: снять двусмысленность до отправки. Как это работает на живой задаче, показано в теме «Пет-проект», раздел «Как поставить задачу агенту: пять частей промпта».
Пример «до и после»:
- Плохо: «сделай текст для кнопки»
- Хорошо: «Ты UX-копирайтер финтех-продукта. Придумай текст для кнопки подтверждения перевода денег. Тон — уверенный, без канцелярита. Формат — 3 варианта по 2–3 слова каждый. Не используй слово "оплатить", у нас уже есть кнопка с этим текстом на другом экране.»
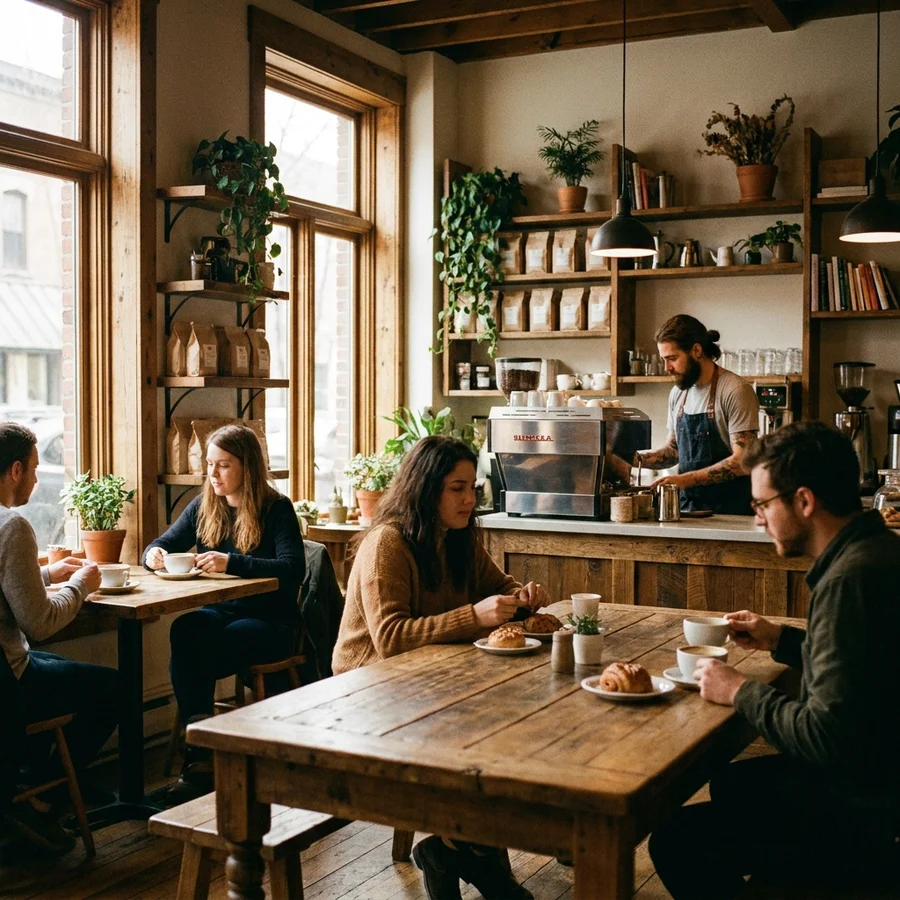
«Сделай красивую картинку для кофейни»: модель выбрала сюжет, кадр и формат сама.
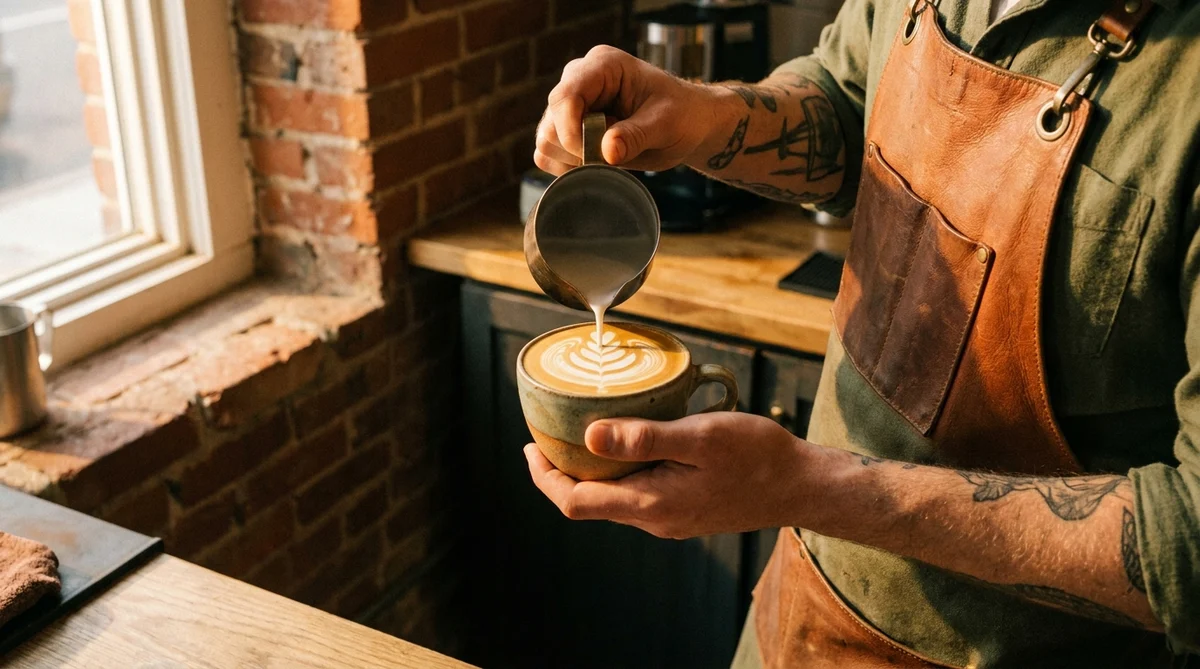
Тот же запрос, разложенный на роль, контекст, задачу, формат и ограничения.
Ты арт-директор маленькой specialty-кофейни в старом кирпичном здании. Сделай главное изображение для её сайта: руки бариста наливают латте-арт, крупный план, тёплый утренний боковой свет, приглушённая землистая палитра, горизонталь 16:9, без текста, лиц не видно.System prompt vs user prompt
В большинстве чат-интерфейсов ты пишешь только «user prompt» — свою реплику. Но за кулисами почти у каждого инструмента есть «system prompt». Это скрытая инструкция от разработчика, которая задаёт базовое поведение модели (например, «отвечай дружелюбно», «никогда не давай медицинских диагнозов»). Дизайнеру полезно знать про это по двум причинам. Во-первых, это объясняет, почему один и тот же вопрос в разных приложениях на одной модели звучит по-разному (например, GPT внутри Notion AI и GPT в чистом ChatGPT). Во-вторых, в некоторых инструментах (кастомные GPT, Gemini Gems, проекты в Claude) ты можешь сам написать «системную» инструкцию один раз. Дальше она применяется ко всем сообщениям в этом чате.
Zero-shot, few-shot и примеры внутри промпта
Zero-shot — это когда просто просишь модель что-то сделать без примеров. Few-shot — когда прикладываешь 2–3 примера того, как должен выглядеть результат, и модель повторяет паттерн. Для дизайнера few-shot особенно полезен в текстах и брифах. Приложи 2 примера уже написанных в тоне бренда текстов — качество результата вырастет сильнее, чем от любых словесных описаний тона. Пример такого few-shot промпта на практике:
Вот два примера, как мы обычно подписываем карточки товара в блоге:
1. «Уютный плед из шерсти — то самое чувство дома в холодный вечер»
2. «Керамическая кружка ручной работы — маленькая деталь, которая меняет утро»

Напиши в этом же тоне подпись для новой карточки: набор ароматических свечей
Многошаговое рассуждение (chain-of-thought)
Фраза «подумай шаг за шагом» или «сначала перечисли варианты, потом выбери лучший и обоснуй» заставляет модель показывать промежуточные рассуждения вместо мгновенного финального ответа. Это особенно полезно в брейншторме и при разборе сложных макетов, где важно видеть логику выбора, а не только вывод.
Одна оговорка. У современных «рассуждающих» моделей (режимы вроде Thinking, Extended thinking, Deep Think в приложениях) пошаговое рассуждение уже встроено: модель сама думает перед ответом, и фраза «подумай шаг за шагом» им почти ничего не добавляет. Им полезнее другое: полный контекст и явное описание того, что считается хорошим результатом. Сам режим рассуждения включай там, где цена ошибки выше цены ожидания ответа. На быстрых моделях без такого режима приём по-прежнему работает. А просьба «сначала перечисли варианты, потом выбери» полезна всегда, потому что показывает логику выбора.
Структурированный вывод
Можно прямо попросить модель вернуть ответ в виде таблицы, нумерованного списка с фиксированными полями или даже в формате JSON. Это удобно, если дальше результат нужно вставить в таблицу Notion, Airtable или передать в другой инструмент.
Мультимодальность
Современные модели (GPT, Gemini, Claude) принимают на вход не только текст, но и картинки, PDF, скриншоты. Gemini принимает ещё и аудио, и видео файлами. Для дизайнера это значит одно: макет больше не нужно описывать словами. Приложи сам макет и попроси его разобрать, доработать или сверстать.
На каком языке писать промпт
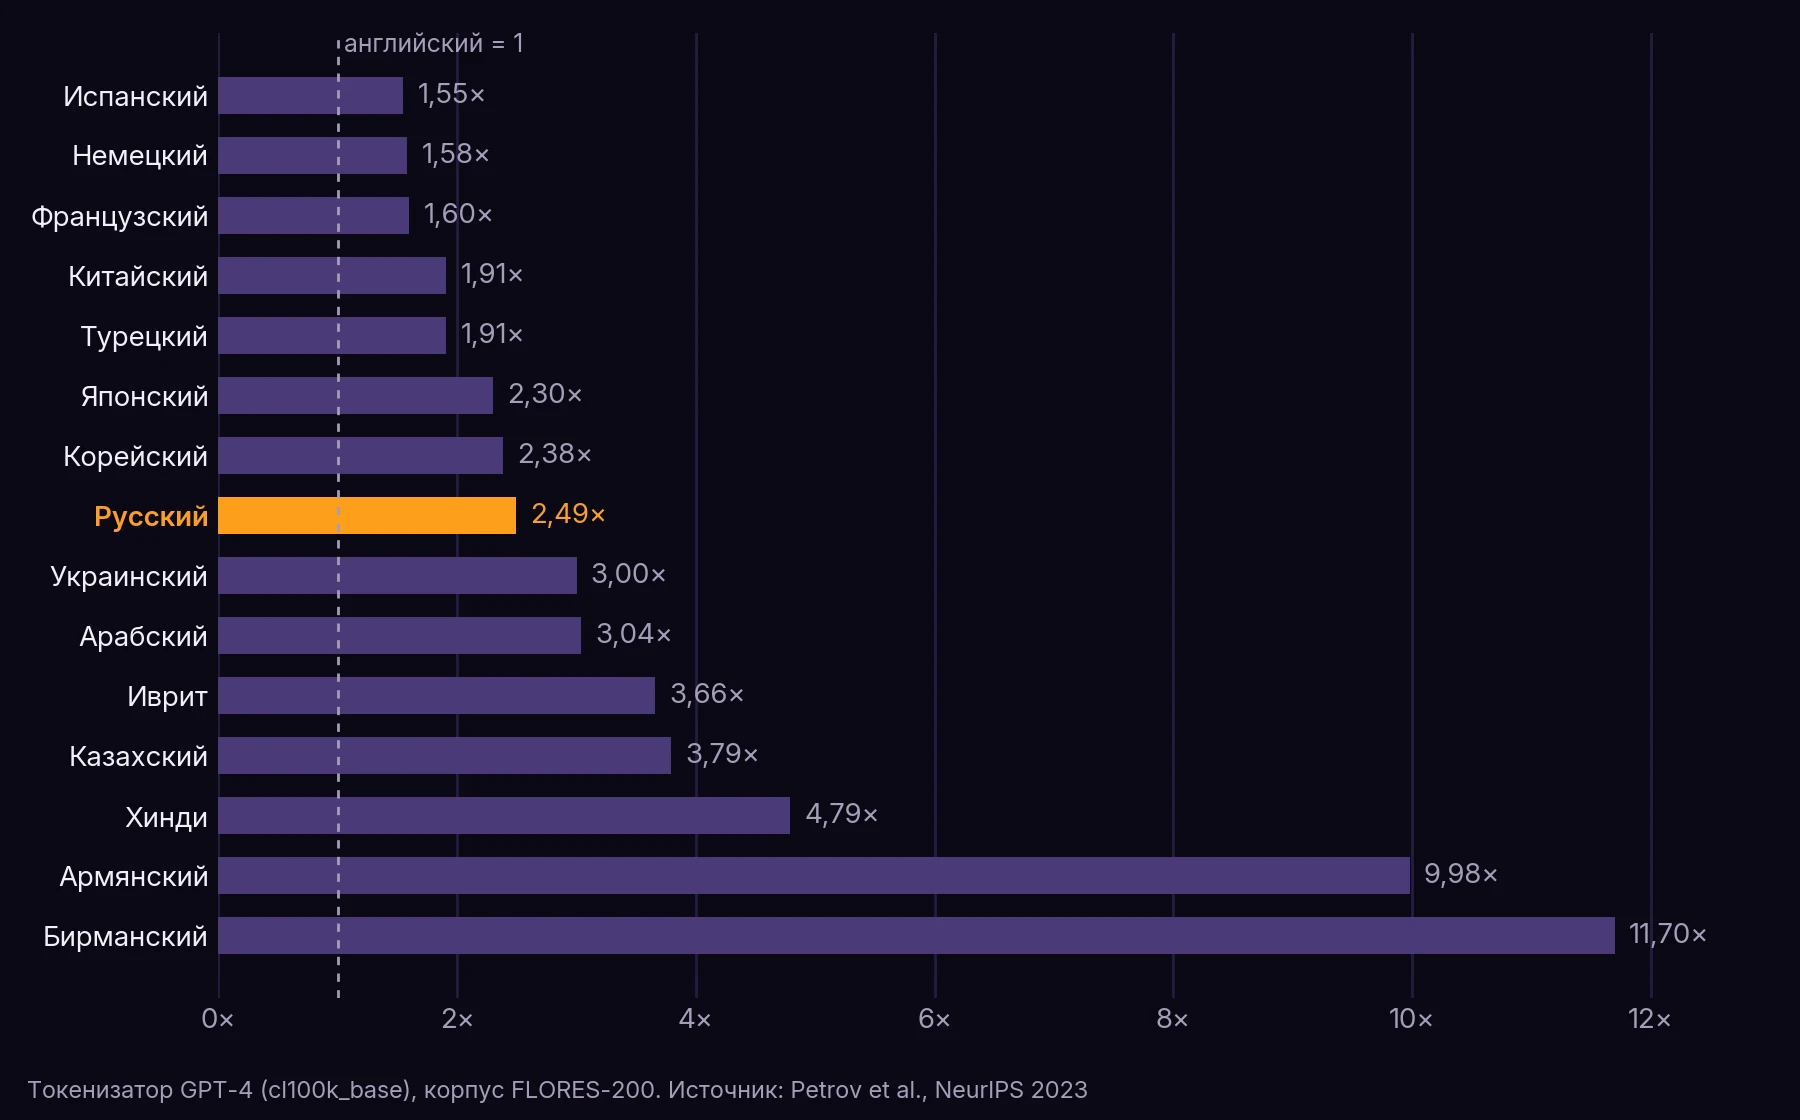
Английского в обучающих данных моделей обычно больше, чем остальных языков: у Llama 3, например, на другие языки пришлось чуть больше 5%. На практике промпт на английском часто даёт более качественный, точный и предсказуемый результат, чем тот же промпт на русском. Особенно это заметно в генерации изображений и видео, где английский де-факто основной язык индустрии. Это не значит, что нужно всегда писать по-английски: для брифов, текстов и общения с клиентом естественно работать на русском. Но если результат на русском промпте разочаровывает, попроси саму модель перевести промпт на английский («переведи этот промпт на английский, сохрани смысл, адаптируй под индустрию дизайна») и сравни результат.
Что делать, когда чат «забывает» начало разговора
У любой модели есть предел объёма текста, который она удерживает в диалоге за раз, — контекстное окно (см. глоссарий). Когда переписка становится очень длинной (десятки сообщений, вставленные большие файлы), самые ранние сообщения могут выпасть из «памяти» модели. Тогда она начинает противоречить тому, что сама говорила в начале, или забывает заданные ограничения. Признак: модель вдруг игнорирует правило, которое чётко соблюдала пятью сообщениями раньше. Решение простое. Не пытайся «дотянуть» один бесконечный чат — начни новый диалог для новой подзадачи. В первое сообщение перенеси только то, что действительно нужно помнить: итог предыдущего этапа и ключевые ограничения. Это надёжнее, и ответы приходят быстрее, чем в разросшемся чате.
Примеры команд для практики
Вот мой промпт: [вставить]. Разбери его по частям: роль, контекст, задача, формат, ограничения — и скажи, каких частей не хватает.Перепиши этот промпт в формате few-shot: вот 2 примера текста в нужном тоне (вставить), теперь напиши третий на ту же тему.Реши эту задачу пошагово, сначала перечисли все возможные подходы, потом выбери лучший и объясни почему: [вставить задачу]Верни ответ в виде таблицы с колонками: идея, плюсы, минусы, сложность реализации.Возьми один реальный промпт, который писал недавно (свой, не из этой темы). Разбери его по пяти частям анатомии из начала темы: роль, контекст, задача, формат, ограничения. Найди, каких частей не хватало, допиши их и сравни результат с тем, что получилось раньше.
Источники
- Language Model Tokenizers Introduce Unfairness Between Languagesarxiv.org
Petrov et al., NeurIPS 2023: на корпусе FLORES-200 токенизатор GPT-4 тратит на русский в 2,49 раза больше токенов, чем на английский; данные графика
- Hello GPT-4oopenai.com
Раздел Language tokenization: новый токенизатор тратит на русский в 1,7 раза меньше токенов
- Migrating to Claude Opus 5.5platform.claude.com
У Opus 5.5 temperature, top_p и top_k можно оставить только по умолчанию, рассуждение включено всегда
- Model guidance (GPT-6 Astra)developers.openai.com
Когда у новых моделей OpenAI недоступны temperature и top_p: только при включённом рассуждении
- Upload & analyze files in Gemini Appssupport.google.com
Gemini принимает аудио и видео файлами, лимиты длины по планам
Нашёл ошибку или устаревший факт? Напиши: hey@iskra.guide